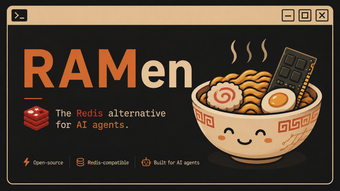
ที่เก็บข้อมูลในหน่วยความจำที่เข้ากันได้กับ Redis พร้อมการค้นหาวัสดุเวกเตอร์ในตัว
RAMen โดย Rohit Dnath เป็นที่เก็บข้อมูลในหน่วยความจำที่สร้างขึ้นเพื่อสนับสนุนการทำงานที่ขับเคลื่อนด้วย AI และหน่วยความจำของเอเจนต์ เครื่องมือนี้รองรับการเข้าถึงแบบคีย์-ค่าในขณะที่เพิ่มการดึงข้อมูลเชิงความหมายเพื่อให้แอปพลิเคชันสามารถดึงเนื้อหาตามความหมายแทนที่จะเป็นการจับคู่ที่แน่นอน มันมุ่งเป้าไปที่นักพัฒนา AI และวิศวกรด้านหลังที่ต้องการที่เก็บข้อมูลในเครื่องเพื่อลดความล่าช้าและหลีกเลี่ยงการเรียกแบบจำลองซ้ำ และรวมเข้ากับระบบนิเวศของเอเจนต์ที่ใช้โปรโตคอลสำหรับการแลกเปลี่ยนบริบทของแบบจำลอง.
คุณสามารถใช้มันทำงานอะไรได้บ้าง?
เครื่องมือนี้ทำหน้าที่เป็นที่เก็บข้อมูลในหน่วยความจำที่รวมการเข้าถึงแบบ Redis เข้ากับการดึงข้อมูลเชิงเวกเตอร์และความหมายสำหรับงาน AI มันรองรับคำสั่งโปรโตคอล Redis เปิดเผยการแคชเชิงความหมายสำหรับการค้นหาที่อิงจากความหมาย และทำงานเป็นเซิร์ฟเวอร์โปรโตคอล Model Context ที่ตัวแทนสามารถสอบถามได้โดยตรง การดำเนินการหลักเขียนด้วย Go และปรับให้เหมาะสมสำหรับประสิทธิภาพในหน่วยความจำ ดังนั้นกรณีการใช้งานจึงรวมถึงการดึงข้อมูลในท้องถิ่นอย่างรวดเร็วสำหรับหน่วยความจำของตัวแทน บริบทเซสชัน และคำตอบ LLM ที่แคชไว้.
การดึงข้อมูลเชิงความหมายสำหรับการทำงานของ AI มีความแม่นยำแค่ไหน?
การแคชเชิงความหมายเก็บและดึงคำตอบ AI ตามความหมายแทนที่จะเป็นการจับคู่คำสำคัญที่แน่นอน การออกแบบนี้มีจุดมุ่งหมายเพื่อลดการเรียก LLM และลดความล่าช้าในระหว่างการดึงข้อมูล การค้นหาเวกเตอร์พื้นเมืองจัดการกับการฝังตัวที่มีมิติสูงเพื่อสนับสนุนการค้นหาดังกล่าว ผลลัพธ์สะท้อนถึงคุณภาพของดัชนีและการฝังตัว ดังนั้นทีมงานควรตรวจสอบคำตอบที่แคชไว้กับข้อมูลแอปพลิเคชันของตนก่อนที่จะพึ่งพาสำหรับการตัดสินใจที่เป็นข้อเท็จจริงหรือมีความเสี่ยงสูง.
มันรองรับสภาพแวดล้อมและลูกค้าใดบ้าง?
โมเดลการจัดจำหน่ายเป็นไฟล์ Go ไบนารีเดียว ซึ่งทำให้การปรับใช้ข้ามระบบที่สามารถเรียกใช้โปรแกรม Go ง่ายขึ้น เครื่องมือนี้ใช้โปรโตคอล Redis แบบดรอปอิน ดังนั้นลูกค้า Redis และโค้ดเบสที่มีอยู่จึงสามารถโต้ตอบได้โดยไม่ต้องปรับเปลี่ยนมากนัก สำหรับการทำงานของตัวแทน มันรวมเข้ากับลูกค้าหรือแพลตฟอร์ม AI ใด ๆ ที่รองรับโปรโตคอล Model Context โดยมีตัวอย่างที่ตั้งชื่อรวมถึง Claude Desktop และ Cursor ซึ่งช่วยให้เข้าถึงข้อมูลโดยตรงจากตัวแทน.
มันง่ายต่อการนำไปใช้ในสแต็กที่มีอยู่หรือไม่?
การนำไปใช้มุ่งเน้นไปที่ความสะดวกสบายของนักพัฒนาและความพร้อมใช้งานแบบโอเพนซอร์ส ใบอนุญาต BSD-3-Clause และโครงการที่โฮสต์บน GitHub ทำให้การนำโค้ดมาใช้ซ้ำเป็นเรื่องง่าย และพื้นฐานของนักพัฒนาที่มีประสบการณ์ในระบบแบ็คเอนด์, Node.js, TypeScript และ Go แสดงให้เห็นถึงความสำคัญของ API และวินัยในการปรับใช้ เนื่องจากเครื่องมือนี้มุ่งเป้าไปที่วิศวกรและผู้สร้างตัวแทน AI คาดว่าจะมีการทำงานที่มุ่งเน้นการพัฒนาซึ่งให้ความสำคัญกับการรวมคลัง, การกำหนดค่าระดับโค้ด และการทดสอบแบบวนซ้ำมากกว่าการบริหารจัดการกราฟิก.
ใครควรพิจารณาเครื่องมือนี้
เครื่องมือเป็นทางเลือกที่เหมาะสมสำหรับทีมวิศวกรรมที่สร้างบริการที่มีตัวแทนซึ่งต้องการการดึงข้อมูลในท้องถิ่นและการควบคุมของนักพัฒนา ทิศทางแบบโอเพนซอร์สสนับสนุนการรวมระบบที่ขับเคลื่อนด้วยที่เก็บ แต่ทีมควรตรวจสอบผลลัพธ์ของ semantic-cache กับชุดข้อมูลของตนและยืนยันว่าตัวแทนของพวกเขาสามารถเข้าถึงที่เก็บได้ผ่านโปรโตคอลบริบทที่จำเป็นก่อนที่จะนำไปใช้ในขนาดใหญ่ ถือว่าเป็นส่วนประกอบทางวิศวกรรม ไม่ใช่ผลิตภัณฑ์สำหรับผู้ใช้ปลายทางที่เสียบและเล่นได้